(※AIで作成しました。)
臨床研究で論文や学会発表の準備をしていると、患者背景の表(いわゆる「Table 1」)の作成に意外と時間を取られてしまいませんか?
Rのパッケージである「tableone」や「gtsummary」を使えば、この作業を一気に効率化できます。今回は、比較的新しく、そのまま論文に使えるほど美しい表を作ってくれる「gtsummary」の基本的な使い方をご紹介します。
以前からあるのが「tableone」で、その後作成されたのが「gtsummary」。gtsummaryは機能が非常に豊富で、現在では「Table 1作成でできないことはほとんどない」と言えるほど優秀です。ここではすべてを紹介しきれないため、臨床研究でよく使う基本的なカスタマイズからWordへの出力方法までをステップ順に解説します。
このwebサイトでわかること
ここでは無料の統計ソフト”R”の患者背景(table.1とも呼ばれるようですが)の作成を一気に作成してくれるgtsummaryの使い方です。ただ、機能がありすぎて、すべてを記載するのは無理。基本的な記載方法のみを作成しています。下記がその内容で、キーとなるコードを記載しておきます。
- 一番簡単な患者背景の作成方法(tbl_summary)
- 日本語への変更(theme_gtsummary_language(“ja”))
- 変数名の変更方法(label)
- 集計する項目の変更・順番の変更(include=c())
- 集計方法を平均・標準偏差へ変更する(theme_gtsummary_mean_sd())
- n 数の追加(add_n())
- P値の代入(add_p())
- P値の解析方法の変更(add_p())
- 全体の集計列を加える(add_overall())
- 表をコンパクトにする(theme_gtsummary_compact() )
- 変数を太文字に変更(bold_labels())
- P値の追加・太文字の両方を行うには
- 設定方法の削除方法(reset_gtsummary_theme() )
- Word・powerpointの形式での保存
あとは、gtsummaryで行えることについて記載しています。
患者背景を簡単に作るには・・・
臨床研究で患者背景を作成するのに便利なパッケージとして使えるのが、「tableone」と「gtsummary」。これらで一気に作成できます。
以前からあるのが「tableone」で、その後作成されたのが「gtsummary」。
というわけで、「gtsummary」を使って作成してみます。
パッケージ「gtsummary」とは・・・
「gtsummary」はRで論文や学会発表にそのまま使えるレベルの美しい集計表(Table 1 や回帰分析の表)を、非常に少ないコードで自動作成するためのパッケージです。
すべてを検証したわけではないですが、現在では「gtsummary」でできないことはそれほどないようです。
「gtsummary」の注意点
gtsummaryはデフォルトの集計が中央値(25%, 75%)、そして統計は症例数や変数が
Wilcoxonの順位和検定(3群以上ならクラスカル・ウォリス検定)となっています。
ですので、違う設定をしたい場合には変更が必要になります。
また、JPEGやPNGの画像として出力することは可能ですが、OFFICEのEXCELやWordとして出力することはできません。そのため、パッケージ:flextableなどを使う必要があります。
gtsummaryでは、デフォルトの集計方法が「中央値(四分位範囲:25%, 75%)」、統計解析は「Wilcoxonの順位和検定(3群以上ならクラスカル・ウォリス検定)」などを自動判定して解析されます。そのため、平均値を使いたい場合や検定方法を変えたい場合は、設定の変更が必要です。
また、そのまま画像(JPEGやPNG)として出力することは可能ですが、WordやPowerPointに直接出力するには、「flextable」という別のパッケージを組み合わせる必要があります。
使用するデータ
今回は「常勤・非常勤の雇用形態で比較する研究」を想定し、以下のダミーデータ(データ名:data)を使用します。(※分かりやすく3名分だけ表示していますが、実際は100人分で解析していると想定してください)
- age:年齢
- sex:性別
- type_of_employment:雇用形態(常勤/非常勤)
- income:収入
- payed_holiday:有給取得日数
| age | sex | type_of_employment | income | payed_holiday |
| 55 | 男性 | 常勤 | 388000 | 5 |
| 60 | 男性 | 非常勤 | 535500 | 7 |
| 63 | 男性 | 常勤 | 1944000 | 15 |
1.パッケージのインストールと読み込み
初回のみパッケージのインストールが必要です。今回は表作成の「gtsummary」、データの操作に「dplyr」、Word出力に「flextable」を使用します。
《入力するコード》#はコメントです
# 初回のみ実行
install.packages(“gtsummary”)
install.packages(“dplyr”)
# パッケージの読み込み
library(gtsummary)
library(dplyr)
2.最もシンプルな表を作成する:
gtsummary のコアとなる関数は tbl_summary() です。これに群分けしたい変数を指定するだけで変数の型を自動判定して集計してくれます。群分けしたい変数は”by=・・・”で指定します。
ちなみに、パイプ 演算子 (%>%) を使用して入力するコードもあります。最近はこちらで記載する方もいらっしゃると思います。結果は一緒なので、両方とも記載したいと思います。
◆パイプ 演算子 (%>%) を使わないコードは下記
(作成する変数) <-tbl_summary (使用するデータ , by= 群分けしたい変数)
《入力するコード》#はコメントです
# 基本のTable 1
table1_base <- tbl_summary(data,by = type_of_employment )
#これでtable1_baseに作成されて下記で出力されます
table1_base
◆パイプ 演算子 (%>%) を使うコードは下記。
(作成する変数) <-使用するデータ %>% tbl_summary ( by= 群分けしたい変数)
《入力するコード》#はコメントです
# 基本のTable 1
table1_base <- data %>% tbl_summary ( by = type_of_employment )
#これでtable1_baseに作成されて下記で出力されます
table1_base
《結果》
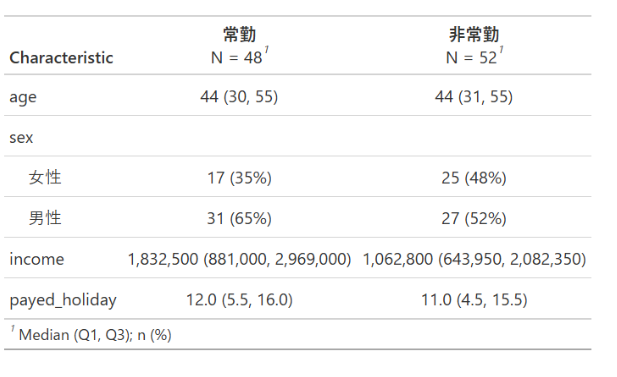
これだけで、カテゴリ変数は「n (%)」、連続変数は「中央値 (四分位範囲)」として集計されます。
※この先はパイプ演算子 (%>%)を使う方法で記載しますが、パイプ (%>%)を使わなくても同じようにできます。
3.表示内容をカスタマイズする:
ここからは、より論文や学会のフォーマットに近づけるためのカスタマイズ方法をご紹介します。
ラベルの日本語化の方法
表の注釈などを日本語にするには、事前にこの1行を実行するだけです。theme_gtsummary_language(“ja”)
“ja”で日本語を指定していますので、他の言語に変える時にはここを変更していきます。
《入力するコード》
theme_gtsummary_language(“ja”)
table1_base <- data %>% tbl_summary ( by = type_of_employment )
table1_base
《結果》
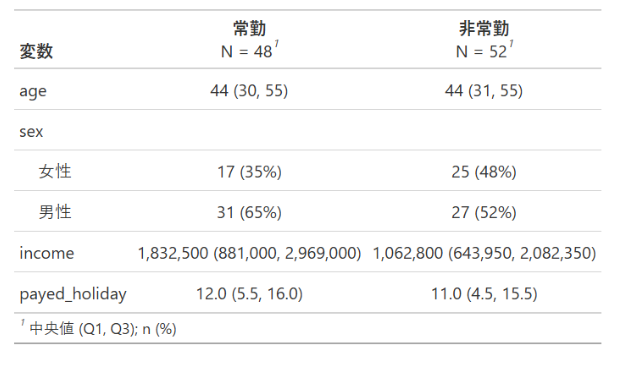
これで、表の下部にある集計方法の説明などが日本語になります。
変数名の変更
変数名を変更する場合にはlabelを使って変更します。というわけで、下記を変更してみましょう。
- age ➡年齢
- sex ➡ 性別
- income ➡ 収入
- payed_holiday ➡ 有給取得日数
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment ,
label =list ( age ~”年齢”, sex ~”性別” , income ~”収入”,
payed_holiday ~”有給取得日数”) )
table1_base
《結果》

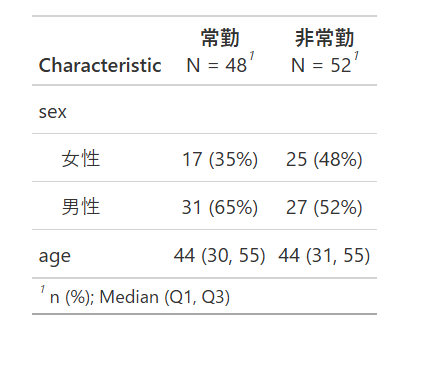
集計する項目の変更・順番の変更
集計する項目を「include=c()」で示せば変更が可能です。記載した順番通りに表示されるので、順番にも気を付けて下さい。
有給を消し、順番を性別➡年齢にしてみましょう。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment , include=c(sex,age))
table1_base
《結果》
集計方法の変更
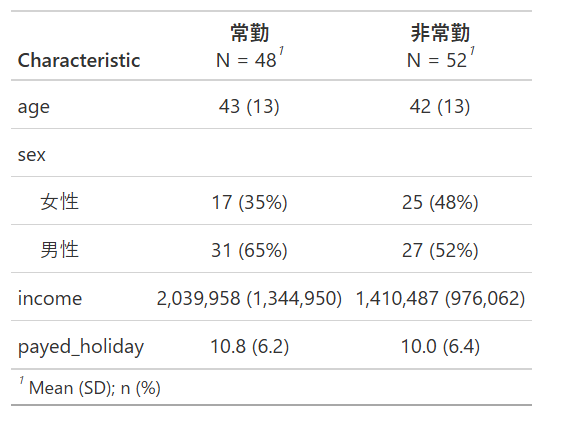
変更をかける前には中央値(四分位範囲)で示されます。
事前にtheme_gtsummary_mean_sd()を実行すれば平均(標準偏差)になります。
《入力するコード》
theme_gtsummary_mean_sd()
table1_base <- data %>% tbl_summary ( by = type_of_employment )
table1_base
《結果》
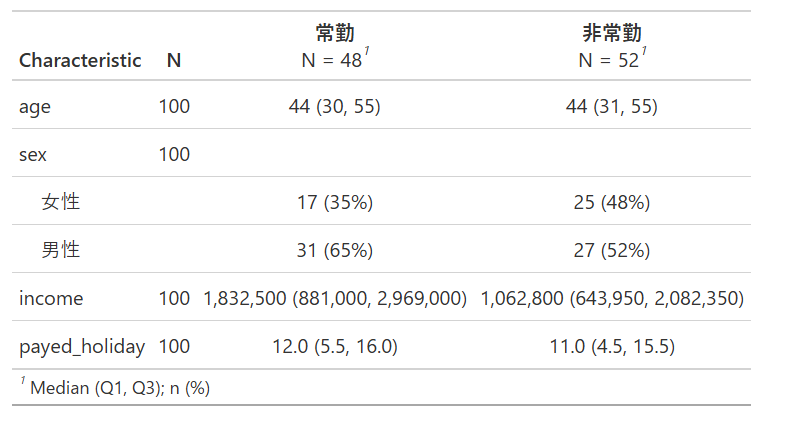
n数(人数)を加える
人数を加える場合は”add_n()”を加えます。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment ) %>%add_n()
table1_base
《結果》
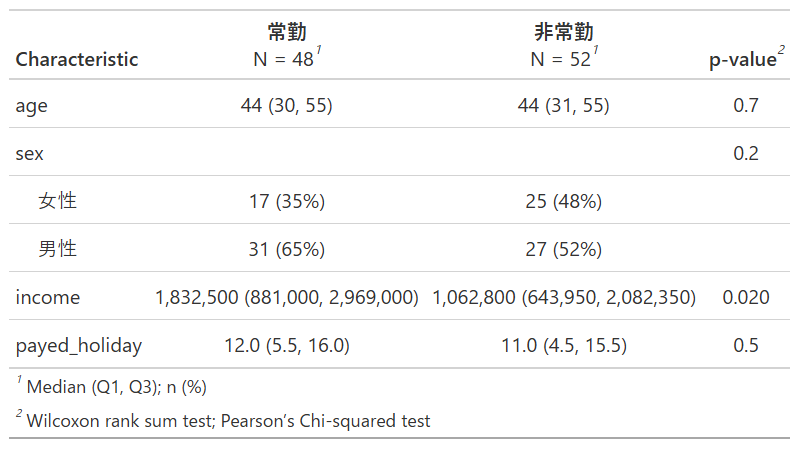
P値の代入/解析方法の変更
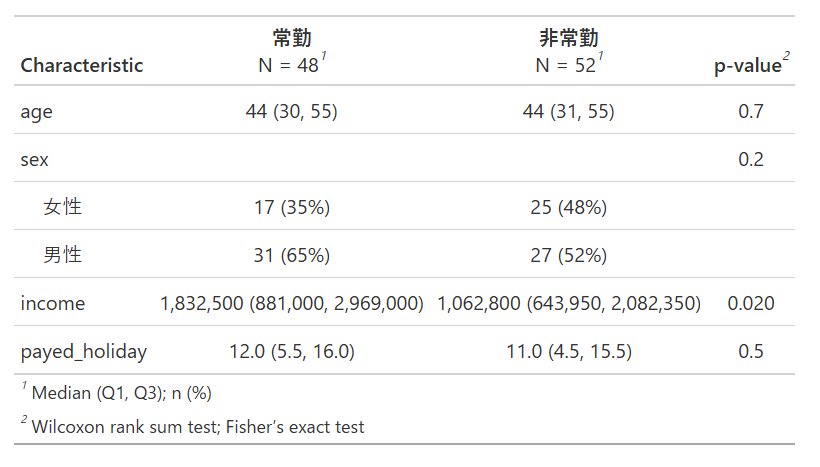
p値を加えるにはadd_p()を追加するだけです。P値の検定方法は、変数の種類や群数によって自動判定されます(表の下部にどの検定が使われたか記載されます)。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment ) %>%add_p
table1_base
《結果》
p値の解析方法を変更するには
P値の検定方法は自動判定されますが、これを手動で指定したい場合は、add_p() の中で指定します。
一括で指定する場合は以下の関数が便利で、カテゴリー変数(常勤 / 非常勤 など)か、連続変数(連続の数:体重とか・)かで指定すると楽です
カテゴリー変数 : all_continuous()
連続変数 : all_categorical()
今回はカテゴリー変数をFisherの正確検定・連続変数をT検定に変えてみましょう。二つ変えるので”list”を使います。
Fisherの正確検定 : fisher.test
T検定 : t.test
で、指定します。他にも多々ありますが、ここでは割愛します。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment )
%>% add_p(test= list(all_categorical()~”fisher.test”,
all_continuous()~”t.test”))
table1_base
《結果》

1個だけ変える場合には”list”を使わずに記載が可能です。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment ) %>%
add_p(test= list(all_categorical()~”fisher.test”,
all_continuous()~”t.test”))
table1_base
《結果》
全体の集計列を加える
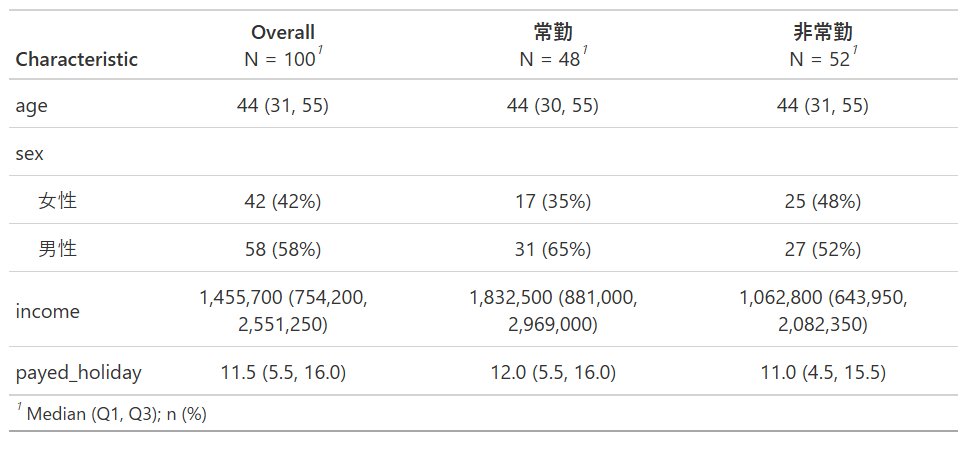
群分けした群の他にすべての症例を合わせた群を追加するには”add_overall()”を追加します
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment )
%>%add_overall()
table1_base
《結果》
表をコンパクトに変更するには・・・
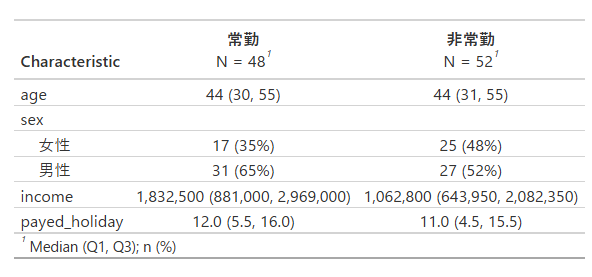
表をコンパクトに変更していく場合には、”theme_gtsummary_compact()”を入力して行っていきます。
《入力するコード》
theme_gtsummary_compact()
table1_base <- data %>% tbl_summary ( by = type_of_employment )
table1_base
《結果》
変数を太文字にするには
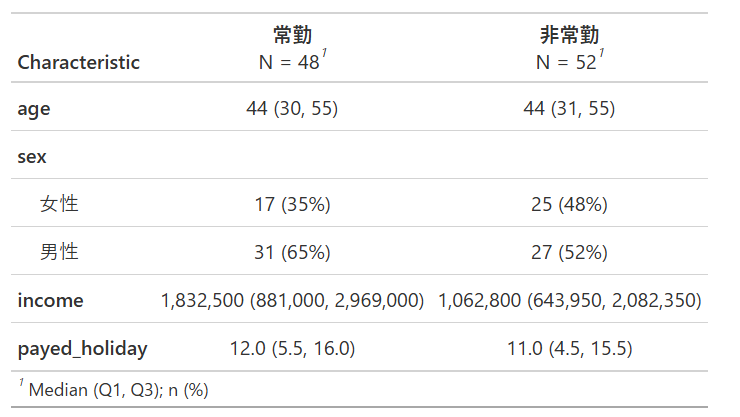
変数名(ラベル)を太字にして見やすくすることもできましす。変数を太文字にする場合には”bold_labels()”を追加します。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment )
%>% bold_labels()
table1_base
《結果》
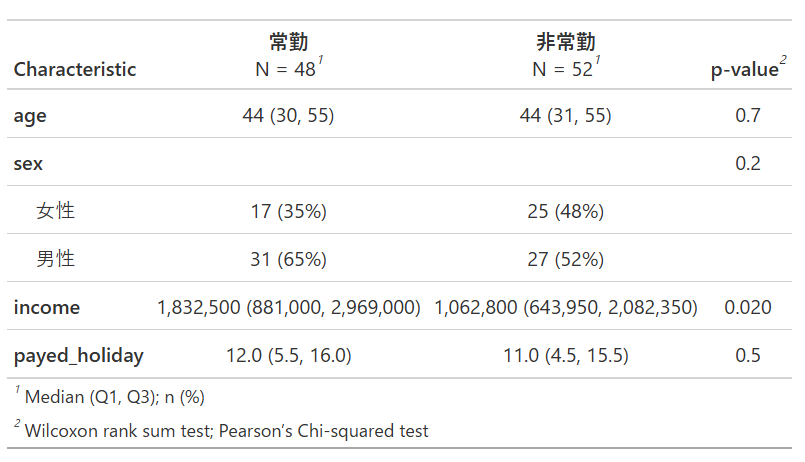
ちなみに太文字+P値を追加するには・・・
P値の追加・太文字の追加は パイプ(%>%)を使って解析します。1個づつ使う場合には上記に示していますが、二つ以上の場合にはそれぞれにパイプ(%>%)をつなげて記載します。
《入力するコード》
table1_base <- data %>% tbl_summary ( by = type_of_employment )
%>% add_p() %>% bold_labels()
table1_base
《結果》
設定をもとに戻すには・・・
いろいろと変更をかけた後に、もとの設定に直すのは下記の一文を入れるだけです。
《入力するコード》
reset_gtsummary_theme()
5.Wordファイルとしてエクスポートする:
完成した美しい表を、そのままWordファイルとして保存しましょう。ここで flextable パッケージを使用します。
《入力するコード》#はコメントです
# 初回のみ実行
install.packages(“flextable”)
# パッケージの読み込み
library(flextable)
#gtsummaryで表を作成
table1_base <- data %>% tbl_summary ( by = type_of_employment )
#flextableを使ってWordに出力します。まずは”table1_base”をflextableの形式へ変更。
flex_output <- as_flex_table(table1_base)
#下記でWordの形式でデータが保存されます。
save_as_docx(flex_output, path = “summary_table.docx”)
《結果》
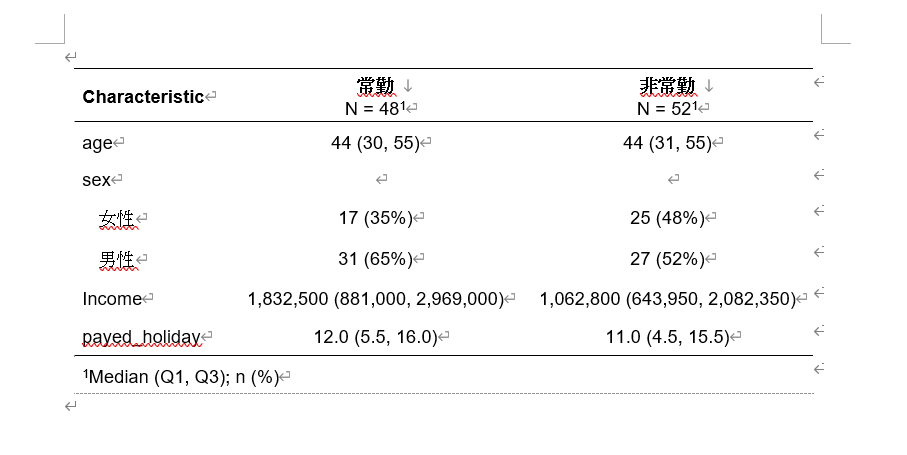
これで、Rの作業フォルダに”summary_table.docx”というWordファイルが出力されます。そんなファイルを作ったことがない方も勝手に作成されています。
“save_as_docx”を“save_as_pptx”へ変更することでpowerpointでの出力が可能です。
「gtsummary」のできる事・・
今回は患者背景のみを作成してみましたが、「gtsummary」で行えることはもっともっとあります。
このパッケージに含まれる関数を集めてみました。すべての項目が検証できていないため、もし異なる事があれば、教えてください。
というか、機能が多くない・・・ ?
1. ベースの表を作成する関数(tbl_*)
一番最初にデータフレームを流し込み、表の骨格を作る関数です。
| 関数名 | 主な用途・出力内容 |
| tbl_summary() | 患者背景表(Table 1)。カテゴリ・連続変数の記述統計 |
| tbl_regression() | 回帰分析(ロジスティック、Cox比例ハザードなど)の結果表 |
| tbl_uvregression() | 複数の変数に対する「単変量解析」を一気に実行して表化 |
| tbl_survival() | 生存時間分析(Kaplan-Meier法)の生存率の表 |
| tbl_cross() | 2変数のクロス集計表(行と列のパーセンテージなど) |
| tbl_svysummary() | IPTWなど、重み付けされたデータ(surveyオブジェクト)の Table 1 |
| tbl_custom_summary() | 平均値だけでなく、割合や特定の計算式を自由に定義して表を作成 |
2. データを追加する関数(add_*)
作成した表に対して、検定結果や全体の列などを付け足す関数です。パイプ(%>%)で繋いで使います。
| 関数名 | 追加される内容 |
| add_p() | 群間比較の p値(適切な検定手法が自動選択される) |
| add_overall() | 全患者(Overall)の集計列 |
| add_smd() | 標準化平均差(傾向スコアマッチングのバランス確認用) |
| add_q() | 多重比較補正を行った q値(FDRなど) |
| add_difference() | 連続変数や割合の「差」とその信頼区間(例:リスク差) |
| add_n() / add_nevent() | 欠損していない N数(例数)や、イベント発生数 |
| add_stat_label() | 「Mean (SD)」や「n (%)」といった統計量の説明ラベル |
| add_global_p() | 3群以上のカテゴリ変数に対する全体としての p値(回帰分析用) |
| add_vif() | 回帰分析における分散拡大要因(VIF、多重共線性の確認用) |
3. 表を結合・分割する関数
単変量解析と多変量解析の結果を並べたい時などに使います。
| 関数名 | 結合の仕方 |
| tbl_merge() | 複数の表を横に結合(例:単変量の表と多変量の表を横に並べる) |
| tbl_stack() | 複数の表を縦に結合(例:異なるモデルの結果を上下に並べる) |
| tbl_strata() | 特定の変数(例:性別や施設)で層別化し、表を複数横に並べる |
4. 見た目・デザインを整える関数(bold_*, modify_*)
WordやHTMLに出力する前に、論文のフォーマットに合わせて装飾します。
| 関数名 | 装飾の内容 |
| bold_labels() | 変数名(ラベル)を太字にする |
| bold_levels() | カテゴリのレベル(Male / Female など)を太字にする |
| bold_p() | 有意な p値(例:p < 0.05)を自動的に太字にする |
| italicize_labels/levels() | ラベルやレベルを斜体にする |
| modify_header() | カラムのヘッダー名(列名)を自由に変更する |
| modify_footnote() | 脚注(表の下の説明文)を変更・追加する |
| modify_caption() | 表のタイトル(キャプション)を設定する |
| modify_column_hide() | 特定の列(信頼区間の列など)を非表示にする |
5. 出力とレポート用関数
| 関数名 | 役割 |
| as_flex_table() | 表を flextable 形式に変換(そのままWordに出力できる) |
| as_gt() | 表を gt 形式に変換(PDFや高画質な画像出力に向いている) |
| inline_text() | R Markdownの本文中に、表の中の「オッズ比」や「p値」を直接埋め込む(数値のコピペミスをゼロにする強力な関数) |
6. 一括でデザインを変える「テーマ」関数
表を一つずつ変更するのではなく、R全体の設定として「この雑誌のフォーマットで作る」「日本語で作る」としてしまう非常に便利な関数群です。
| 関数名 | 主な用途・出力内容 |
| theme_gtsummary_journal() | 表の出力形式を JAMA, NEJM, Lancet などの有名医学雑誌の投稿規定に一瞬で合わせます(p値の丸め方や信頼区間の表記ルールなどが自動変更されます)。 |
| theme_gtsummary_language() | 出力される言語を指定します(”ja” にすると「Unknown」が「不明」になるなど、デフォルトの英語が翻訳されます)。 |
| theme_gtsummary_compact() | 表の行間を詰めて、コンパクトなレイアウトにします(Word出力時に表が大きくなりすぎるのを防ぎます)。 |
| reset_gtsummary_theme() | 設定したテーマをすべてリセットし、デフォルトに戻します。 |
7. 記述統計 にさらに細かい指標を追加する関数
記述統計(Table 1)に対して、p値以外のマニアックな情報を足したい場合に使います。
| 関数名 | 追加される内容 |
| add_ci() | 平均値や割合の**「95%信頼区間(CI)」**をTable 1に追加します。割合のCIを厳密に出したい記述疫学の研究で必須です。 |
| add_stat() | 自分で作った任意の計算式(オリジナルの統計量)を表の新しい列として追加できる、拡張用関数です。 |
| modify_spanning_header() | カラムの上に**「親ヘッダー(またがり見出し)」**を追加します(例:「A群」と「B群」の上に「介入グループ」という大枠のヘッダーをつける)。 |
8. 生存時間分析(Kaplan-Meier)に特化した関数
前回少し触れましたが、生存時間分析(Time-to-event データ)の集計表を作る専用関数群です。
| 関数名 | 主な用途・出力内容 |
| tbl_survfit() | survival パッケージで作成したKaplan-Meier曲線の結果(例:1年生存率、3年生存率、中央生存期間など)を美しい表にします。 |
| add_p.tbl_survfit() | 上記の表に、Log-rank検定などのp値を追加します。 |
参考:使用したデータ
今回使用したデータは下記になります。私が乱数を使って作成した仮想データです。
| age | sex | type_of_employment | income | payed_holiday |
| 55 | 男性 | 常勤 | 388000 | 5 |
| 60 | 男性 | 非常勤 | 535500 | 7 |
| 63 | 男性 | 常勤 | 1944000 | 15 |
| 47 | 男性 | 常勤 | 2512000 | 16 |
| 36 | 男性 | 非常勤 | 1057600 | 0 |
| 45 | 男性 | 非常勤 | 1836000 | 3 |
| 32 | 女性 | 非常勤 | 65500 | 1 |
| 34 | 女性 | 非常勤 | 771400 | 12 |
| 27 | 男性 | 常勤 | 543000 | 13 |
| 34 | 男性 | 常勤 | 3228000 | 18 |
| 56 | 男性 | 常勤 | 931000 | 19 |
| 57 | 男性 | 非常勤 | 2590500 | 16 |
| 24 | 男性 | 非常勤 | 603600 | 12 |
| 63 | 男性 | 常勤 | 5539000 | 1 |
| 38 | 男性 | 常勤 | 349000 | 16 |
| 40 | 男性 | 常勤 | 3673000 | 17 |
| 23 | 男性 | 非常勤 | 274400 | 3 |
| 29 | 男性 | 常勤 | 1445000 | 13 |
| 32 | 女性 | 非常勤 | 499000 | 14 |
| 35 | 男性 | 非常勤 | 421600 | 8 |
| 62 | 男性 | 非常勤 | 2674800 | 8 |
| 57 | 女性 | 非常勤 | 1795200 | 15 |
| 59 | 男性 | 常勤 | 2152000 | 7 |
| 21 | 男性 | 常勤 | 1828000 | 5 |
| 35 | 男性 | 常勤 | 2114000 | 12 |
| 54 | 女性 | 非常勤 | 120000 | 13 |
| 49 | 女性 | 常勤 | 553000 | 16 |
| 28 | 女性 | 常勤 | 1206000 | 0 |
| 43 | 女性 | 常勤 | 3060000 | 10 |
| 37 | 女性 | 非常勤 | 1068000 | 20 |
| 57 | 男性 | 非常勤 | 1494500 | 14 |
| 23 | 女性 | 非常勤 | 76200 | 6 |
| 63 | 男性 | 非常勤 | 2698500 | 20 |
| 44 | 女性 | 常勤 | 737000 | 8 |
| 31 | 女性 | 非常勤 | 1041000 | 19 |
| 28 | 男性 | 常勤 | 1769000 | 7 |
| 31 | 女性 | 非常勤 | 1093400 | 16 |
| 40 | 男性 | 非常勤 | 912000 | 0 |
| 62 | 男性 | 非常勤 | 3026500 | 7 |
| 53 | 女性 | 常勤 | 24000 | 13 |
| 55 | 女性 | 常勤 | 4495000 | 13 |
| 44 | 男性 | 非常勤 | 1029000 | 3 |
| 45 | 女性 | 非常勤 | 2444400 | 6 |
| 59 | 女性 | 非常勤 | 1704000 | 1 |
| 38 | 男性 | 非常勤 | 917700 | 14 |
| 57 | 女性 | 常勤 | 3360000 | 5 |
| 52 | 男性 | 非常勤 | 960500 | 17 |
| 29 | 男性 | 常勤 | 2878000 | 10 |
| 28 | 女性 | 非常勤 | 1003500 | 6 |
| 64 | 男性 | 常勤 | 1272000 | 4 |
| 52 | 男性 | 非常勤 | 3191200 | 3 |
| 24 | 女性 | 非常勤 | 533600 | 6 |
| 49 | 男性 | 常勤 | 4127000 | 12 |
| 57 | 男性 | 非常勤 | 2793000 | 12 |
| 49 | 男性 | 非常勤 | 624400 | 2 |
| 57 | 女性 | 非常勤 | 481200 | 12 |
| 47 | 女性 | 常勤 | 3161000 | 6 |
| 63 | 男性 | 常勤 | 4600000 | 3 |
| 55 | 女性 | 常勤 | 1299000 | 9 |
| 53 | 男性 | 常勤 | 25000 | 20 |
| 50 | 男性 | 非常勤 | 663500 | 3 |
| 25 | 女性 | 常勤 | 711000 | 16 |
| 29 | 男性 | 常勤 | 2341000 | 4 |
| 44 | 男性 | 非常勤 | 2183500 | 19 |
| 56 | 男性 | 常勤 | 3725000 | 19 |
| 31 | 女性 | 非常勤 | 906500 | 16 |
| 28 | 男性 | 非常勤 | 1118500 | 0 |
| 62 | 女性 | 常勤 | 1824000 | 8 |
| 29 | 女性 | 非常勤 | 976200 | 1 |
| 37 | 女性 | 常勤 | 807000 | 19 |
| 44 | 女性 | 非常勤 | 1299900 | 9 |
| 23 | 男性 | 常勤 | 622000 | 17 |
| 37 | 男性 | 常勤 | 115000 | 19 |
| 56 | 女性 | 非常勤 | 3852800 | 16 |
| 47 | 女性 | 非常勤 | 452000 | 14 |
| 42 | 男性 | 常勤 | 831000 | 0 |
| 49 | 女性 | 非常勤 | 3659200 | 19 |
| 27 | 男性 | 常勤 | 2374000 | 6 |
| 49 | 女性 | 常勤 | 1761000 | 0 |
| 21 | 女性 | 非常勤 | 1296000 | 11 |
| 50 | 女性 | 常勤 | 3347000 | 19 |
| 38 | 女性 | 常勤 | 1837000 | 0 |
| 26 | 男性 | 非常勤 | 2052800 | 19 |
| 33 | 男性 | 非常勤 | 736200 | 18 |
| 59 | 男性 | 非常勤 | 457800 | 9 |
| 31 | 男性 | 常勤 | 1599000 | 4 |
| 32 | 女性 | 非常勤 | 1466400 | 11 |
| 52 | 男性 | 非常勤 | 2198700 | 9 |
| 24 | 男性 | 非常勤 | 874400 | 0 |
| 25 | 男性 | 非常勤 | 1509600 | 19 |
| 27 | 女性 | 常勤 | 2618000 | 7 |
| 58 | 女性 | 非常勤 | 3367700 | 12 |
| 34 | 男性 | 常勤 | 2232000 | 12 |
| 23 | 男性 | 常勤 | 1013000 | 10 |
| 39 | 男性 | 常勤 | 2743000 | 16 |
| 57 | 女性 | 常勤 | 1304000 | 17 |
| 50 | 男性 | 常勤 | 4273000 | 20 |
| 28 | 女性 | 非常勤 | 1824000 | 14 |
| 51 | 女性 | 非常勤 | 2111900 | 6 |
| 59 | 男性 | 常勤 | 2629000 | 12 |
コメント